Strata LLM (stratallm.org): 125B MoE-Modelle lokal auf 12 GB VRAM ausführen
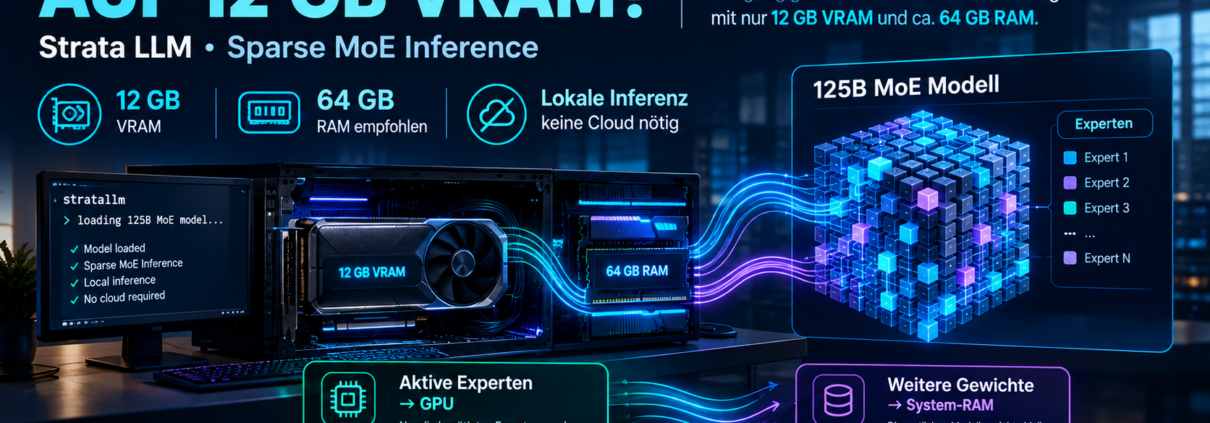
Die Anforderungen moderner Frontier-Klassiker im Open-Weight-Bereich wachsen stetig. Modelle mit der Mixture-of-Experts-Architektur (MoE) – wie Qwen3.8-Flash-Next 125B oder Mixtral – bieten zwar extrem hohe Modellkapazität, scheiterten bisher jedoch an der harten VRAM-Grenze lokaler Consumer-Grafikkarten.
Mit dem Open-Source-Projekt Strata LLM (stratallm.org) steht Entwicklern, Researchern und Homelab-Betreibern nun eine spezialisierte Inference-Engine unter MIT-Lizenz zur Verfügung, die Server-Klasse-Modelle auf normalen Desktop-Computern nutzbar macht.
Die Kern-Technologie: Dynamic Sparse Router Offloading
Herkömmliche Inferenz-Pipelines wie llama.cpp oder Ollama versuchen bei vollem Offloading, sämtliche Gewichte in den Videospeicher der Grafikkarte zu laden. Reicht der VRAM nicht aus, wird auf den System-RAM zurückgegriffen, was bei unoptimiertem Paging oft zu massiven Stotterern und extrem langsamen Token-Raten führt.
Strata gelingt der Durchbruch über eine dreistufige Architektur:
1. Predictive Sparse Routing
MoE-Modelle aktivieren pro Token immer nur einen Bruchteil ihrer Gesamt-Parameter (z. B. 2 bis 8 aus 64 Experten). Strata analysiert den Inferenz-Verlauf und antizipiert 1 bis 2 Tokens im Voraus, welche Expert-Schichten aufgerufen werden.
2. Tiered VRAM-RAM Caching
-
Im GPU-VRAM (z. B. 12 GB): Verbleiben dauerhaft der KV-Cache, die grundlegenden Attention-Heads und die am häufigsten getriggerten Experten.
-
Im System-RAM (z. B. 64 GB DDR5): Verbleiben die restlichen, seltener benötigten Experten-Parameter, die bei Bedarf via PCIe gestreamt werden.
3. Zero-Copy Pinned Memory
Über asynchrone CUDA-Streams schaufelt Strata die benötigten Experten-Gewichte per Direct Memory Access (DMA) direkt über die PCIe-3.0/4.0/5.0-Schnittstelle in die Tensor Cores der Grafikkarte. Dadurch treten keine CPU-Rechenengpässe auf.
Hardware-Voraussetzungen & Kompatibilität
| Komponente | Mindestanforderung | Empfehlung |
| GPU (VRAM) | Mind. 12 GB VRAM (RTX 3060 / 4060 Ti) | 16 GB+ VRAM (RTX 4080 / 4090 / 5090) |
| System-RAM | 64 GB DDR4 / DDR5 | 64 GB – 128 GB High-Speed DDR5 |
| Speicher | NVMe SSD (PCIe 3.0 / 4.0) | PCIe 4.0/5.0 NVMe SSD |
| Lizenz | MIT License (Open Source) | – |
Integration in bestehende Entwickler-Tools
Ein großes Plus von Strata LLM ist der eingebaute Webserver (Standard-Port 8080). Dieser stellt Endpunkte zur Verfügung, die sich wie Standard-Schnittstellen von Cloud-Anbietern verhalten:
-
OpenAI-Kompatibilität:
/v1/chat/completions,/v1/models -
Anthropic-Kompatibilität:
/anthropic/v1/messages
Dadurch lässt sich Strata ohne zusätzlichen Middleware-Aufwand direkt als lokales Backend in Entwicklungsumgebungen und Frontends einbinden:
-
IDE Assistants: Continue.dev, Cursor AI
-
UI Frontends: Open-WebUI, LibreChat
-
SDKs: LangChain, LlamaIndex, Python
openai-Library
Fazit & Einordnung
Strata LLM zeigt eindrucksvoll, dass nicht immer teure Server-Hardware nötig ist, um mit modernsten Frontier-Modellen lokal zu arbeiten. Für Entwickler, die Wert auf Datenschutz, Unabhängigkeit von Cloud-Schnittstellen und volle Kontrolle über ihre KI-Workloads legen, ist Strata ein hervorragender Baustein für das eigene Homelab.
Offizielle Projektseite & Doku: stratallm.org